AI 模型排名史(2020 至 2026):从 GPT-3 到 Gemini 4 的每一任第一
指南更新于 16 分钟阅读
2023 年以来,只有四家实验室在 Arena 榜单上以第一名收官过一个月。逐月看 GPT-4、Claude、Gemini、Grok 和 Kimi 的排名竞赛,每个分数都注明出处。
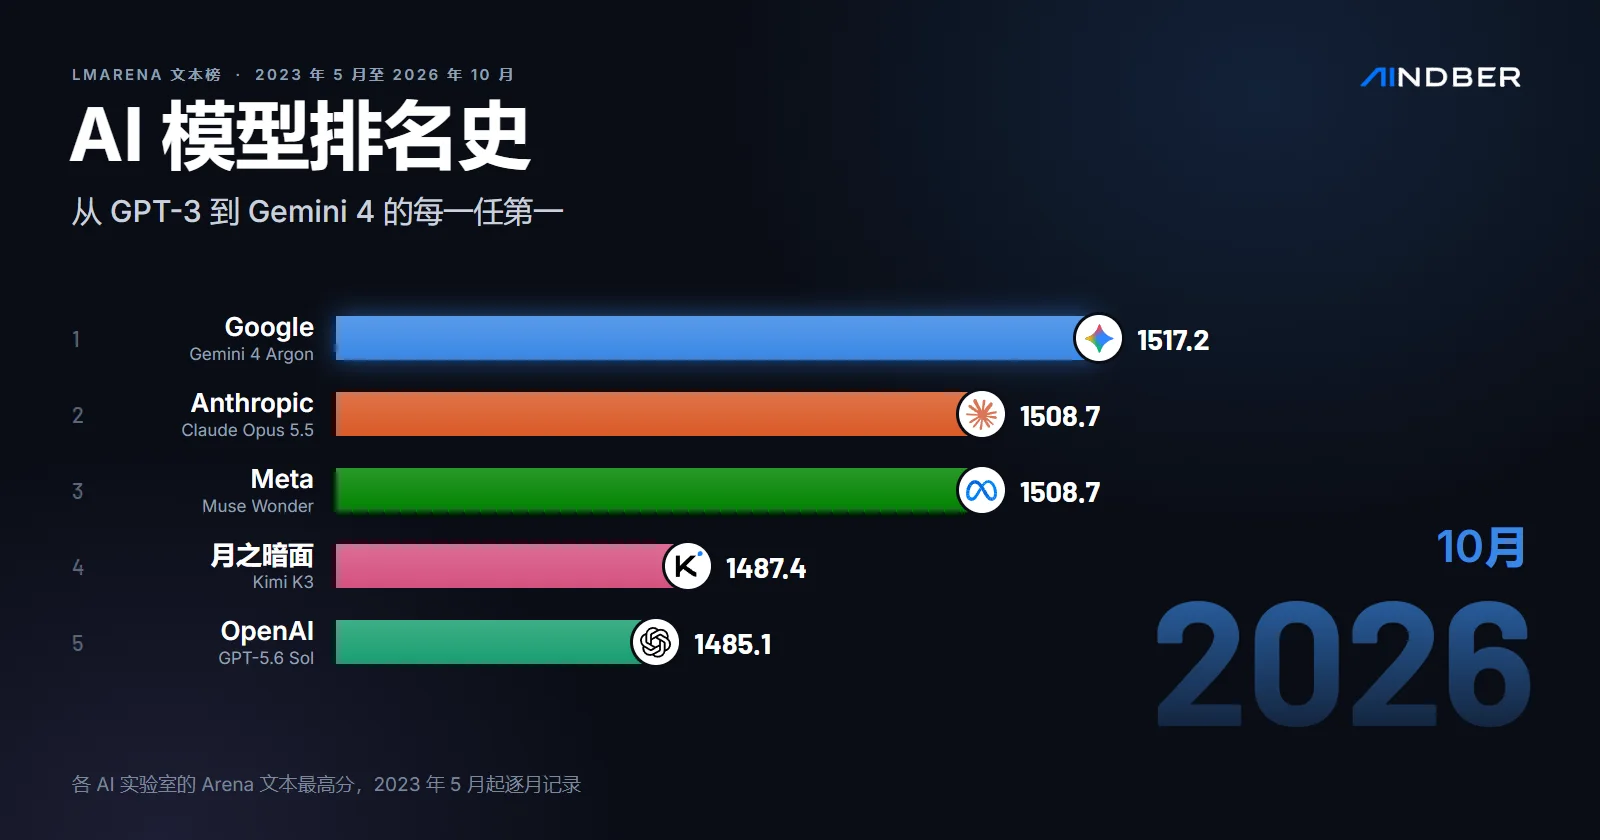
数据抓取时间: 2026 年 10 月 24 日(UTC)。其中最新的一版榜单发布于 2026 年 10 月 22 日,所以图表里的 10 月只覆盖了三周。
作者 Frankie C. · Mindber 高级市场研究员。通过 Mindber Innovation Index 方法追踪东南亚市场 500 多个 AI/SaaS 工具。
评估方式: 我们读取了 Arena 在 2023 年 5 月到 2025 年 8 月间保存的每一份文本总榜快照。此后发布的榜单来自它在 Hugging Face 上公开的历史数据集。每个月我们只取最后一版榜单,再取每家实验室在这版榜单上得分最高的模型。2023 年以前的分数来自各模型发布时的论文。这是对公开数据的整理,不是上手测试,每个月的数字都在图表下方的 CSV 里。
2023 年 5 月 Arena 文本榜开张以来,只有四家 AI 实验室以第一名结束过一个月。OpenAI 做到了 17 个月,Google 16 个月,Anthropic 8 个月,xAI 1 个月。榜单的头十个月,第一一直是 OpenAI 的 GPT-4 系列。此后第一名在不同实验室之间易手了七次。
Arena 靠人投票排名,不靠考试分数。访客输入一个问题,并排拿到两个匿名模型的回答,选出更好的那个,投完票才看到模型名字。数以百万计的投票,最终换算成一个类似国际象棋等级分的分数。
按下播放,42 个月的榜单变化一次看完,再往下读每次换位背后的原因。
每根柱子代表一家实验室当月最后一版文本总榜上得分最高的模型。坐标轴从略低于最短柱子的位置起算,而不是从零开始。
2026年10月Meta 的 Muse Wonder 与 Claude Opus 5.5 并列第二


居首月数2023年5月以来位居第一的月数 OpenAI17 个月
 Google16 个月当前第一
 Anthropic8 个月
 xAI1 个月
OpenAI17 个月Google16 个月当前第一Anthropic8 个月xAI1 个月2026年10月:Google以 1517 分领先
| 排名 | 实验室 | 当月最佳模型 | 得分 | 居首月数 |
|---|---|---|---|---|
| 1 | Gemini 4 Argon | 1517 | 16 | |
| 2 | Anthropic | Claude Opus 5.5 | 1509 | 8 |
| 3 | Meta | Muse Wonder | 1509 | 0 |
| 4 | 月之暗面 | Kimi K3 | 1487 | 0 |
| 5 | OpenAI | GPT-5.6 Sol | 1485 | 17 |
| 6 | 阿里巴巴 | Qwen3.8-Max | 1483 | 0 |
| 7 | 智谱 | GLM-5.3 | 1481 | 0 |
| 8 | 小米 | MiMo-V2.6-Pro | 1480 | 0 |
| 9 | DeepSeek | DeepSeek-V4.1 Flash | 1476 | 0 |
| 10 | xAI | Grok 4.20 Beta | 1475 | 1 |
| 11 | 百度 | ERNIE 5.1 | 1467 | 0 |
| 12 | 字节跳动 | Seed 2.0 | 1456 | 0 |
| 13 | 腾讯 | Hunyuan HY3 | 1454 | 0 |
| 14 | 阶跃星辰 | Step 5 Preview | 1448 | 0 |
| 15 | MiniMax | MiniMax-M3 | 1440 | 0 |
| 16 | 美团 | LongCat-Flash | 1436 | 0 |
| 17 | Mistral AI | Mistral Large 4 | 1434 | 0 |
| 18 | 英伟达 | Nemotron 3 Ultra | 1426 | 0 |
| 19 | Cohere | Command A | 1354 | 0 |
| 20 | Ai2 | Olmo 3.1 32B | 1329 | 0 |
| 21 | 零一万物 | Yi-Lightning | 1328 | 0 |
| 22 | Nexusflow | Athene-V2 | 1314 | 0 |
| 23 | Reka | Reka Core | 1288 | 0 |
| 24 | 微软 | Phi-4 | 1256 | 0 |
| 25 | Hugging Face | Zephyr ORPO 141B | 1213 | 0 |
| 26 | OpenChat | OpenChat 3.5 | 1183 | 0 |
| 27 | LMSYS | Vicuna-33B | 1173 | 0 |
| 28 | UC Berkeley | Starling-7B | 1168 | 0 |
| 29 | MosaicML | MPT-30B-Chat | 1151 | 0 |
| 30 | TII | Falcon-180B | 1148 | 0 |
| 31 | 华盛顿大学 | Guanaco-33B | 1128 | 0 |
| 32 | 斯坦福 | Alpaca-13B | 1070 | 0 |
| 33 | Nomic AI | GPT4All-13B | 1068 | 0 |
| 34 | RWKV | RWKV-4 Raven | 1042 | 0 |
| 35 | OpenAssistant | OpenAssistant Pythia | 1024 | 0 |
来源: LMArena 榜单历史数据 · 月度数据(CSV) · 制作你自己的动态排名图
每根柱子是一家实验室,标着它当月最好的模型。这种分数没有真正意义上的零点,所以坐标轴从略低于画面里最短柱子的位置起算,随整体水平移动。柱子下方的面板统计每家位居第一的月数,点开表格可以看到当月每家实验室的分数。图里的 35 家实验室,都至少进过一次前十。
同一场竞赛的 75 秒短片,每一次第一名的更替都在里面:
Arena 之前:GPT-3 到 GPT-4 考的是同一场试
2020 年还没人用投票给聊天机器人排名,因为公众手里根本没有聊天机器人。各家实验室比的是基准测试,比较的对象都是大语言模型。最后留下来的是 MMLU,一套覆盖 57 个科目的选择题,由 Dan Hendrycks 等人在 2020 年 9 月发表。纯靠猜能拿 25%。
当年夏天发布的最大版 GPT-3,在 MMLU 自己的论文里只拿了 43.9%。DeepMind 的 Gopher 在 2021 年底做到 60.0%。Google 的 PaLM 在 2022 年 4 月做到 69.3%。ChatGPT 在 2022 年 11 月 30 日上线,背后是 GPT-3.5,OpenAI 后来公布它的成绩是 70.0%。
在提示里给出五道例题时的答对比例,取自各模型论文。纯猜可得 25。
GPT-4(2023 年 3 月)
86.4/100
GPT-3.5(2022 年 11 月)
70/100
PaLM 540B(2022 年 4 月)
69.3/100
Chinchilla(2022 年 3 月)
67.6/100
LLaMA 65B(2023 年 2 月)
63.4/100
Gopher(2021 年 12 月)
60/100
GPT-3 175B(2020 年)
43.9/100
0255075100
Source: MMLU 论文及各模型技术报告, Oct 24, 2026
接着,据 GPT-4 技术报告,GPT-4 在 2023 年 3 月比前代高出 16 分,这场考试顶端已经没剩多少空间。公开考试还有一个毛病:题目可能混进下一代模型的训练数据。排名需要一个背不下来的裁判,Arena 正好补上。
2023 年:GPT-4 坐稳第一,开放模型争第五
LMSYS 是从加州大学伯克利分校起家的研究团队,它在 2023 年 5 月 3 日推出 Chatbot Arena。第一版榜单只排了九个开放模型,自家的 Vicuna-13B 以 1169 分居首。几天之内闭源模型就加了进来。到 5 月底,GPT-4 以 1225 分领先,Claude 1 以 1195 分紧随其后。
GPT-4 一整年都没丢掉第一,最后取代它的是自家后继者。OpenAI 在 11 月开发者大会上发布的 GPT-4 Turbo,在 11 月 16 日的榜单上登顶。
Anthropic 这一年有个怪现象:Claude 1 一直压着本该接替它的新模型。12 月 20 日的榜单上,Claude 1 是 1149 分,Claude 2.0 是 1131 分,Claude 2.1 是 1117 分。投票的人不会因为模型更新就多给分。
两家闭源实验室之下,榜单属于大学和小团队,大多是在 Meta 的 LLaMA 上做微调。Vicuna 出自 LMSYS,Koala 出自伯克利,Guanaco 出自华盛顿大学,WizardLM 出自微软的研究人员。所以 2023 年的柱子里会出现斯坦福、MosaicML 和 RWKV。这些开放模型里最好的排在第五或第六,落后 GPT-4 大约 80 到 170 分。Meta 在 7 月发布了开放权重的 Llama 2。12 月,Mistral 的 Mixtral 8x7B 成为榜上最强的开放模型。
2024 年 3 月:GPT-4 第一次丢掉第一
先松动的是 Google。2024 年 1 月,当时跑着 Gemini Pro 的 Bard 一下跳到第二,仅次于 GPT-4 Turbo。
Anthropic 在 3 月 4 日发布 Claude 3。到月底,Claude 3 Opus 拿到 1253.6 分,只比 GPT-4 Turbo 高 2.4 分。这是 GPT-4 加入 Arena 以来,榜首第一次不是 OpenAI 的模型。
Arena 自己的表格把这么小的差距当作平手。每个分数都带置信区间,区间重叠的模型共享同一名次。下面这条 4 月 11 日的帖子里,四个模型并列第一,GPT-4 Turbo 的 4 月新版排在最前面。
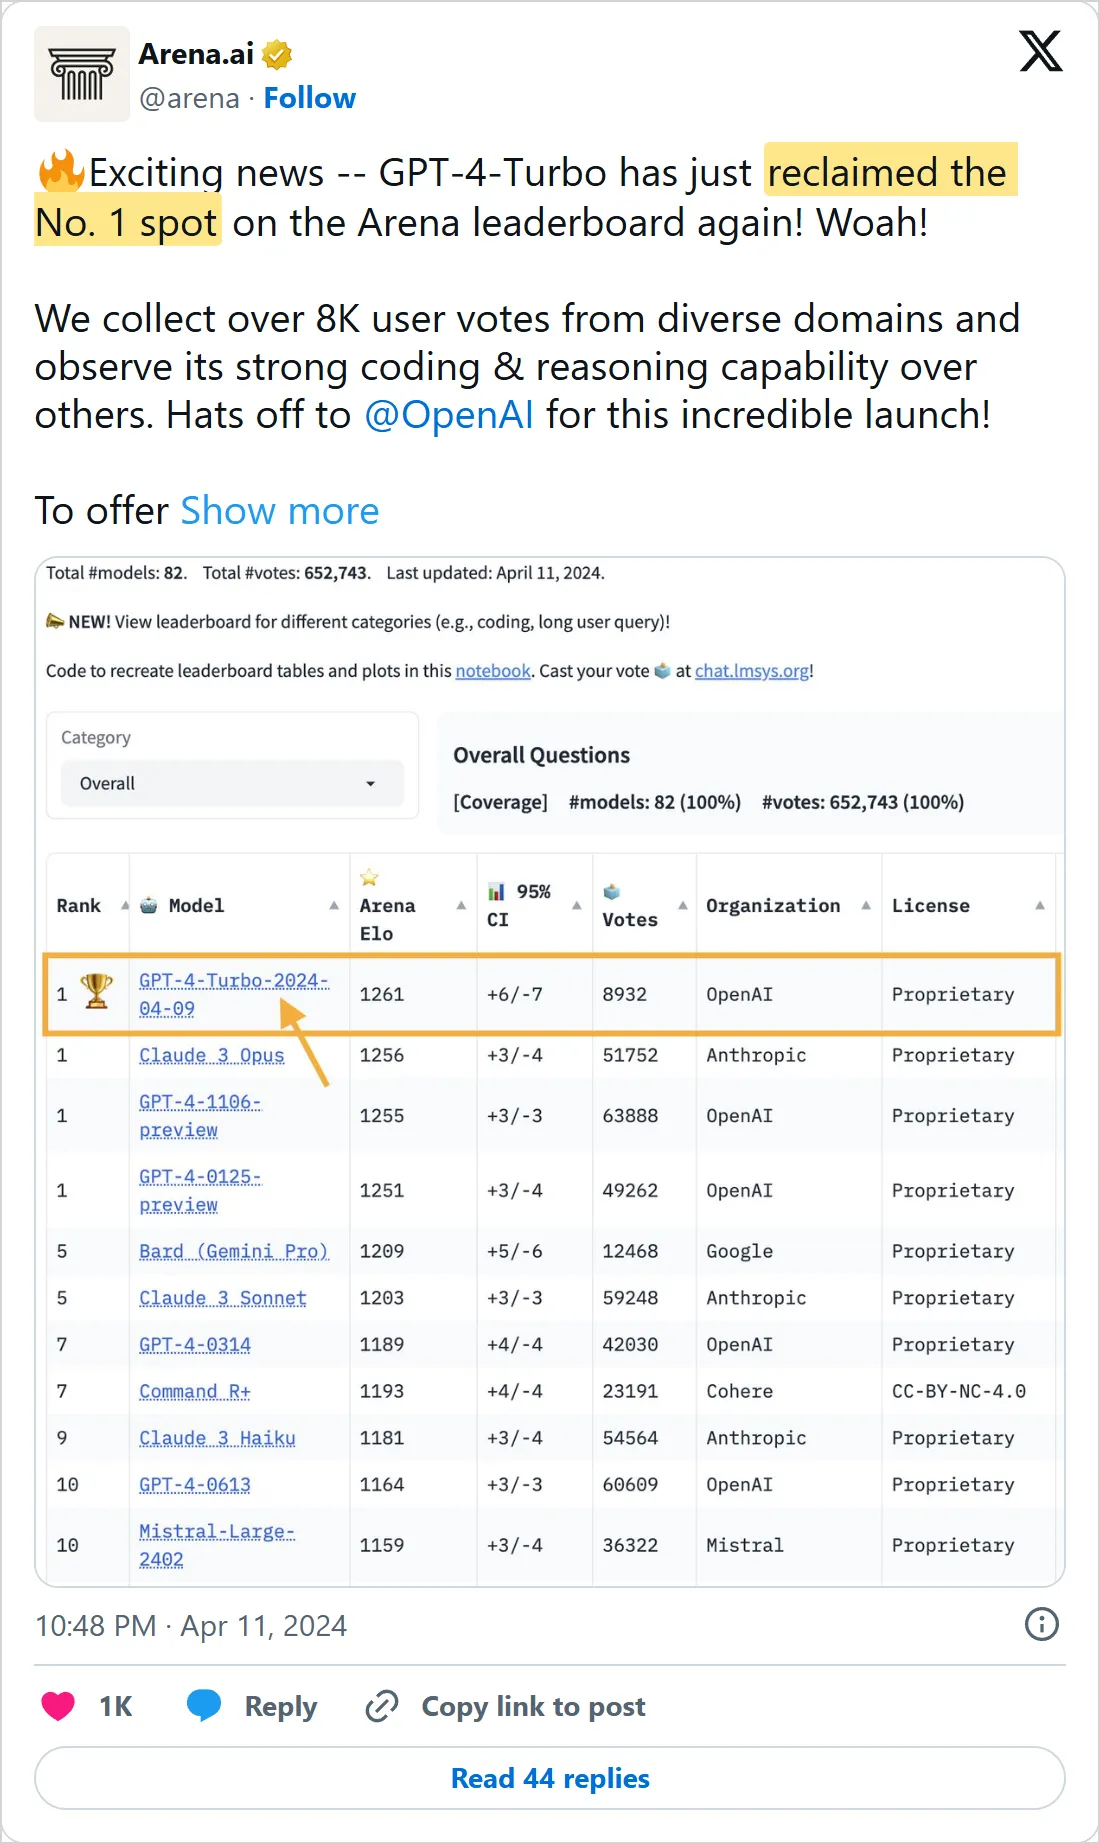
Arena 当时还用 LMSYS 账号发帖。四个模型置信区间重叠,所以并列第一。时间为 UTC。来源:x.com/lmsysorg/status/1778555678174663100
代号测试和 gpt2-chatbot 那一周
实验室会用代号把未发布的模型放上 Arena 测试,投票的人不知道自己在看谁的回答。2024 年 5 月初,一个叫 im-also-a-good-gpt2-chatbot 的匿名模型赢个不停,网上很多人都在猜它的来历。
5 月 13 日 OpenAI 揭晓了答案。研究员 Liam Fedus 发帖说,这个模型就是 GPT-4o,还附上了下面这张评分图。预览里它是 1310 分,比 GPT-4 Turbo 的 4 月版高出 57 分。
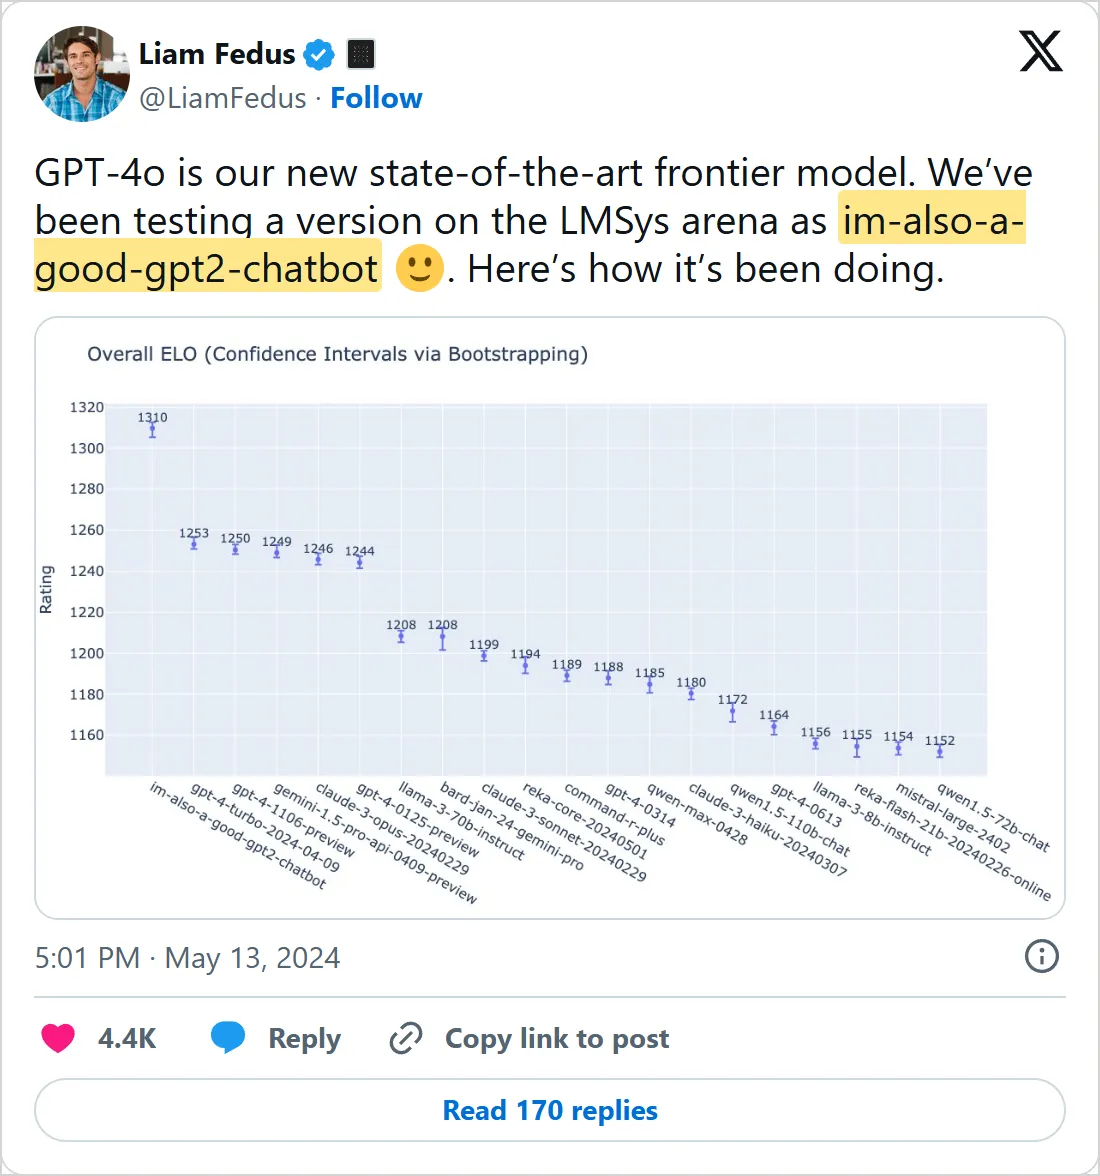
OpenAI 的 Liam Fedus 在发布当天公开代号。时间为 UTC。来源:x.com/LiamFedus/status/1790064963966370209
换回真名之后,GPT-4o 到 5 月底稳定在 1287 分。这种回落很正常。几千票算出的分数,比几万票算出的波动大得多,所以新模型上线时的领先常常会缩水。看任何新模型上榜第一周的成绩,都要记住这一点。
推理模型登场,Google 首次登顶
Google 第一次拿到第一,是在 2024 年 8 月 1 日的榜单上。实验版 Gemini 1.5 Pro(exp-0801)拿到 1300 分,GPT-4o 是 1286 分。不到月底,OpenAI 的新版 ChatGPT-4o 又回到了前面。
9 月来了 o1-preview,这是 OpenAI 的第一个推理模型。它会先在看不见的步骤里把问题想一遍再作答,当月月底就排在榜首。如今榜单前列很多都是推理模型,名字后面常带着 High 或 Max 之类的推理强度。
2024 年 11 月是榜首最热闹的一个月。11 月 13 日的榜单由 Gemini-Exp-1114 领先。一周后,ChatGPT-4o 的 11 月 20 日更新接过第一,第二天 Gemini-Exp-1121 又抢了回去。此后 Google 靠 Gemini-Exp-1206 和 Gemini 2.0 Flash Thinking 一直领先到 1 月。
DeepSeek 在 2025 年 1 月 20 日以 MIT 许可证发布 R1,任何人都可以下载运行。到 1 月 28 日,它在榜上排第六,高过 Anthropic 和 Meta 的所有模型。2 月,xAI 拿到了它唯一一个月的第一,靠的是早期版本的 Grok 3,1403.5 分。
Google 连续领先十一个月
Gemini 2.5 Pro 在 2025 年 3 月 25 日一上榜就是第一。Arena 说这是它记录过的最大分数跃升。Google 此前用代号 "nebula" 在榜上测试过这个模型。
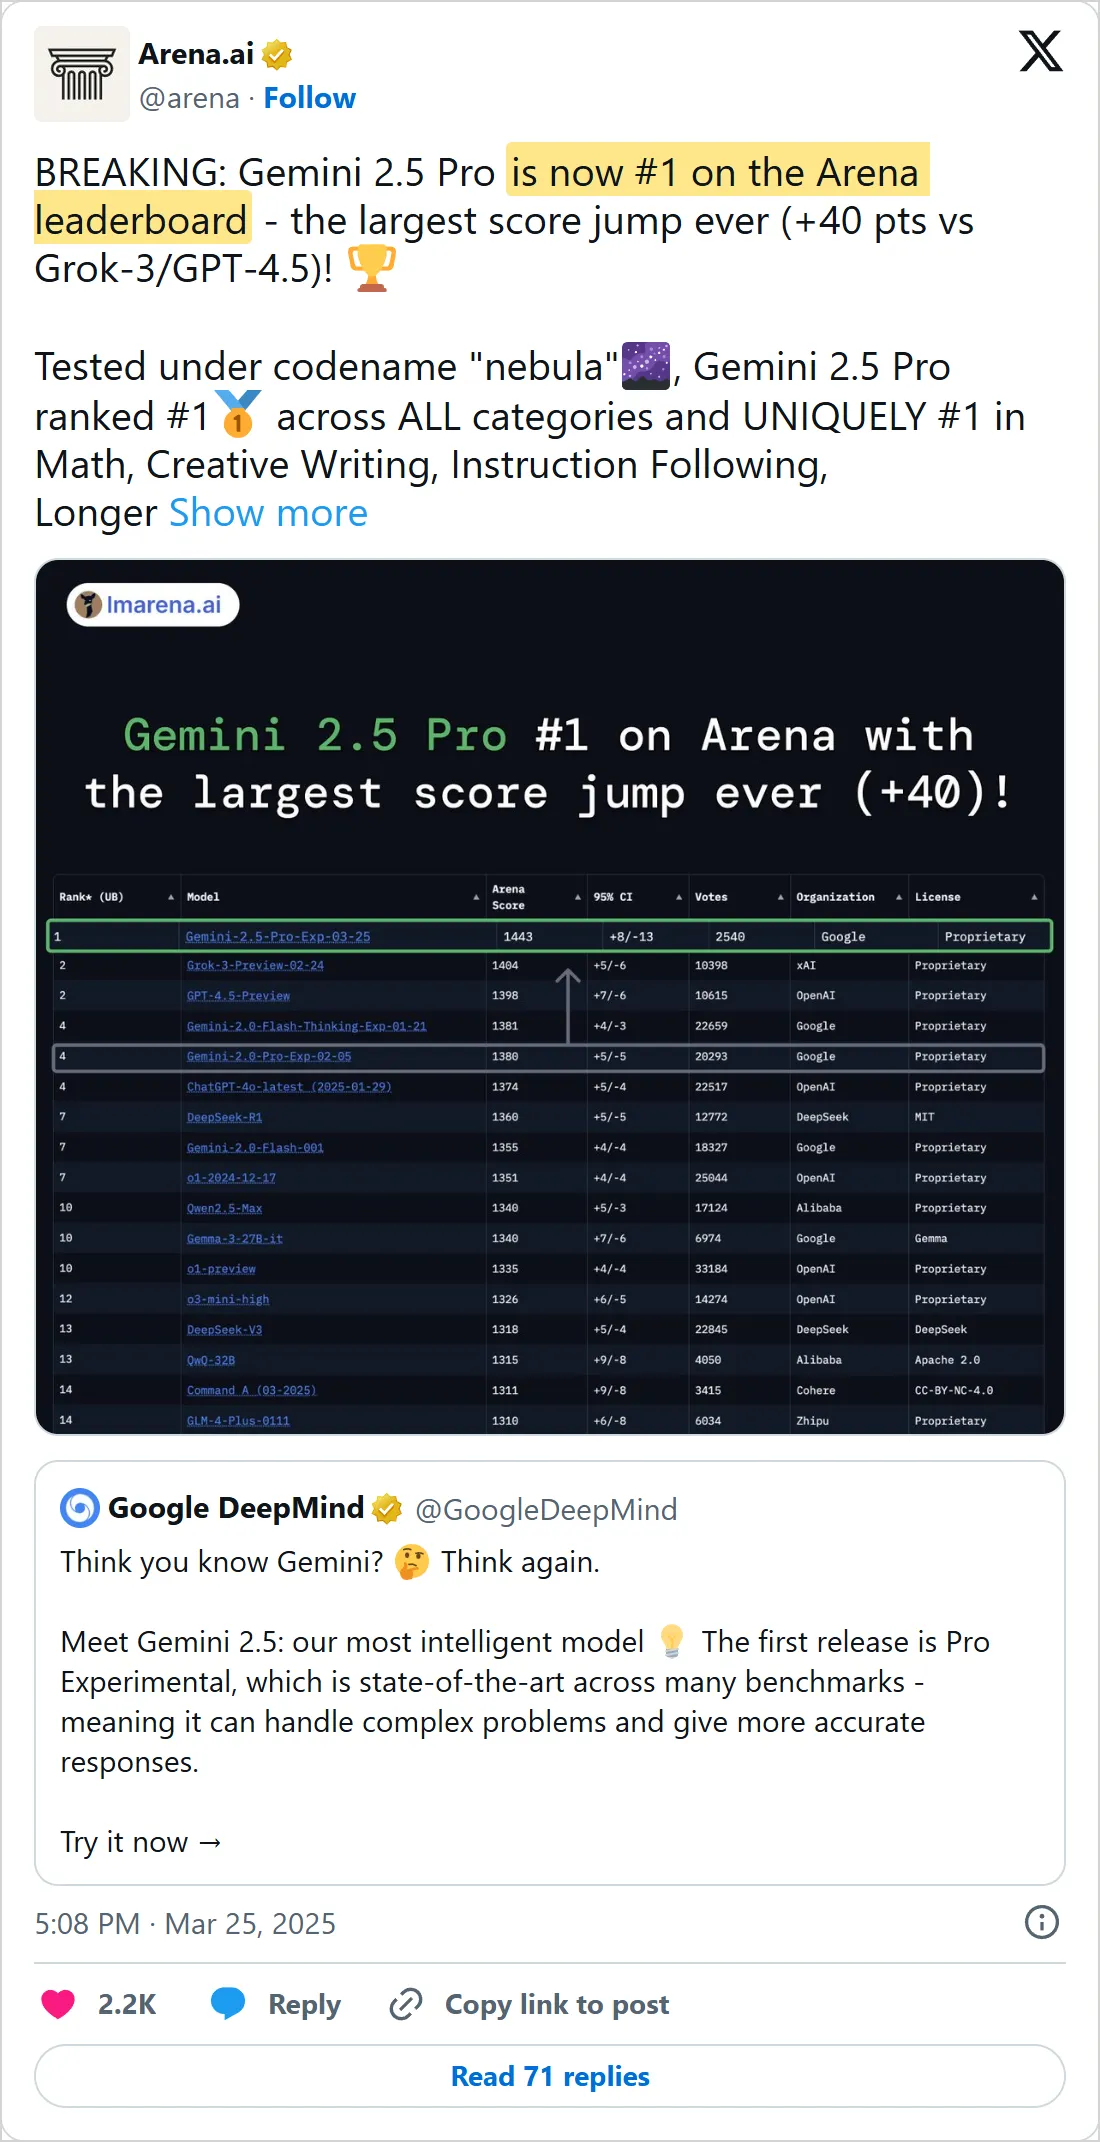
Arena 在发布当天的帖子:1443 分,Grok-3-Preview 是 1404 分,GPT-4.5-Preview 是 1398 分。时间为 UTC。来源:x.com/lmarena_ai/status/1904581128746656099
此后 Google 连续十一个月在月底领先,先是这个模型的三个版本,再是 Gemini 3 Pro。这段时间里有两个对手短暂冲上过第一。GPT-5 在 2025 年 8 月 7 日发布当天登顶,到 8 月 21 日 Google 又回到前面。10 月 3 日,Claude Sonnet 4.5 Thinking 以不到一分的优势领先,四天后被反超。月底快照把这两次都藏起来了,这是按月推进的图表要付的代价。
2025 年 11 月 16 日,Gemini 3 Pro 上榜,成为第一个分数超过 1500 的模型。
Anthropic 的 2026 年,以及 10 月 22 日的榜单
Claude Opus 4.6 在 2026 年 2 月 6 日的榜单上登顶。此后直到 8 月,Anthropic 每个月底都排第一,先后靠 Opus 4.6、Opus 4.7,6 月起是 Claude Fable 5。Fable 5 首次上榜就是 1510 分,是当时榜上出现过的最高分。6 月 9 日发布三天后,美国政府的一道命令让 Fable 5 下线,但在停用的三周里,Arena 照常公布它的分数。
9 月 30 日,Google 带着 Gemini 4 Argon 回到第一,比第二名高出 19 分。
Arena 文本榜,取每月最后一版,2023 年 5 月至 2026 年 10 月(42 个月)
OpenAI
17/42
Google
16/42
Anthropic
8/42
xAI
1/42
011213242
Source: LMArena 榜单历史数据,Mindber 整理, Oct 24, 2026
10 月 22 日的榜单上,Gemini 4 Argon (High) 以 1517.2 分领先。Claude Opus 5.5 (High) 和 Meta 新推出的 Muse Wonder (Max) 都是 1508.7 分,并列第二。Google 的领先是真的,但很薄,三者的置信区间互有重叠。Anthropic 胜在厚度:前 14 名里有 9 个是 Claude 模型。我们的 Model Arena 排行榜同步这份排名的最新版本,目前收录 418 个模型。
OpenAI 是这份榜单上的意外。它最好的是 GPT-5.6 Sol (xHigh),1485.1 分,排第 21 名,在各实验室里只排第五,月之暗面开放权重的 Kimi K3 还略高于它。GPT-6 系列排得更靠后:GPT-6.1 Sol (Max) 第 27 名,GPT-6 Astra (Max) 第 32 名。文本榜衡量的是人们更喜欢哪个聊天回答,OpenAI 的最新模型暂时还没赢下这场投票。
开放权重模型还落后多少?
开放权重模型是指训练好的权重任何人都能下载,并在自己的硬件上运行的模型。最好的开放模型和榜首之间的差距是一级一级缩小的,每一级都对应一次发布。
Arena 文本榜,取当月最后一版。柱子越短,开放模型离榜首越近。
2023 年 5 月:Vicuna-13B
171/180
2023 年 12 月:Mixtral 8x7B
122/180
2025 年 7 月:Kimi K2
43/180
2026 年 10 月:Kimi K3
30/180
2024 年 7 月:Llama 3.1 405B
24/180
2025 年 1 月:DeepSeek-R1
24/180
2026 年 8 月:Kimi K3
19/180
04590135180
Source: LMArena 榜单历史数据与许可证标注,Mindber 整理, Oct 24, 2026
第一个标杆是 Meta 立的。它最大的开放模型 Llama 3.1 405B 在 2024 年 7 月的榜单上排第五。从 2024 年 12 月起,每个月底最好的开放模型都来自中国实验室:DeepSeek、月之暗面、智谱或阿里巴巴。"开放"背后的许可证差别很大,从 MIT 到 Kimi K3 许可证这样的自定义条款都有,拿来做产品之前要逐条看清。
Arena 自己的帖子也记录了这个变化。2026 年 4 月,它把 Kimi K2.6 列为文本榜第二好的开放模型,在 Code Arena 网页开发榜上排第六。
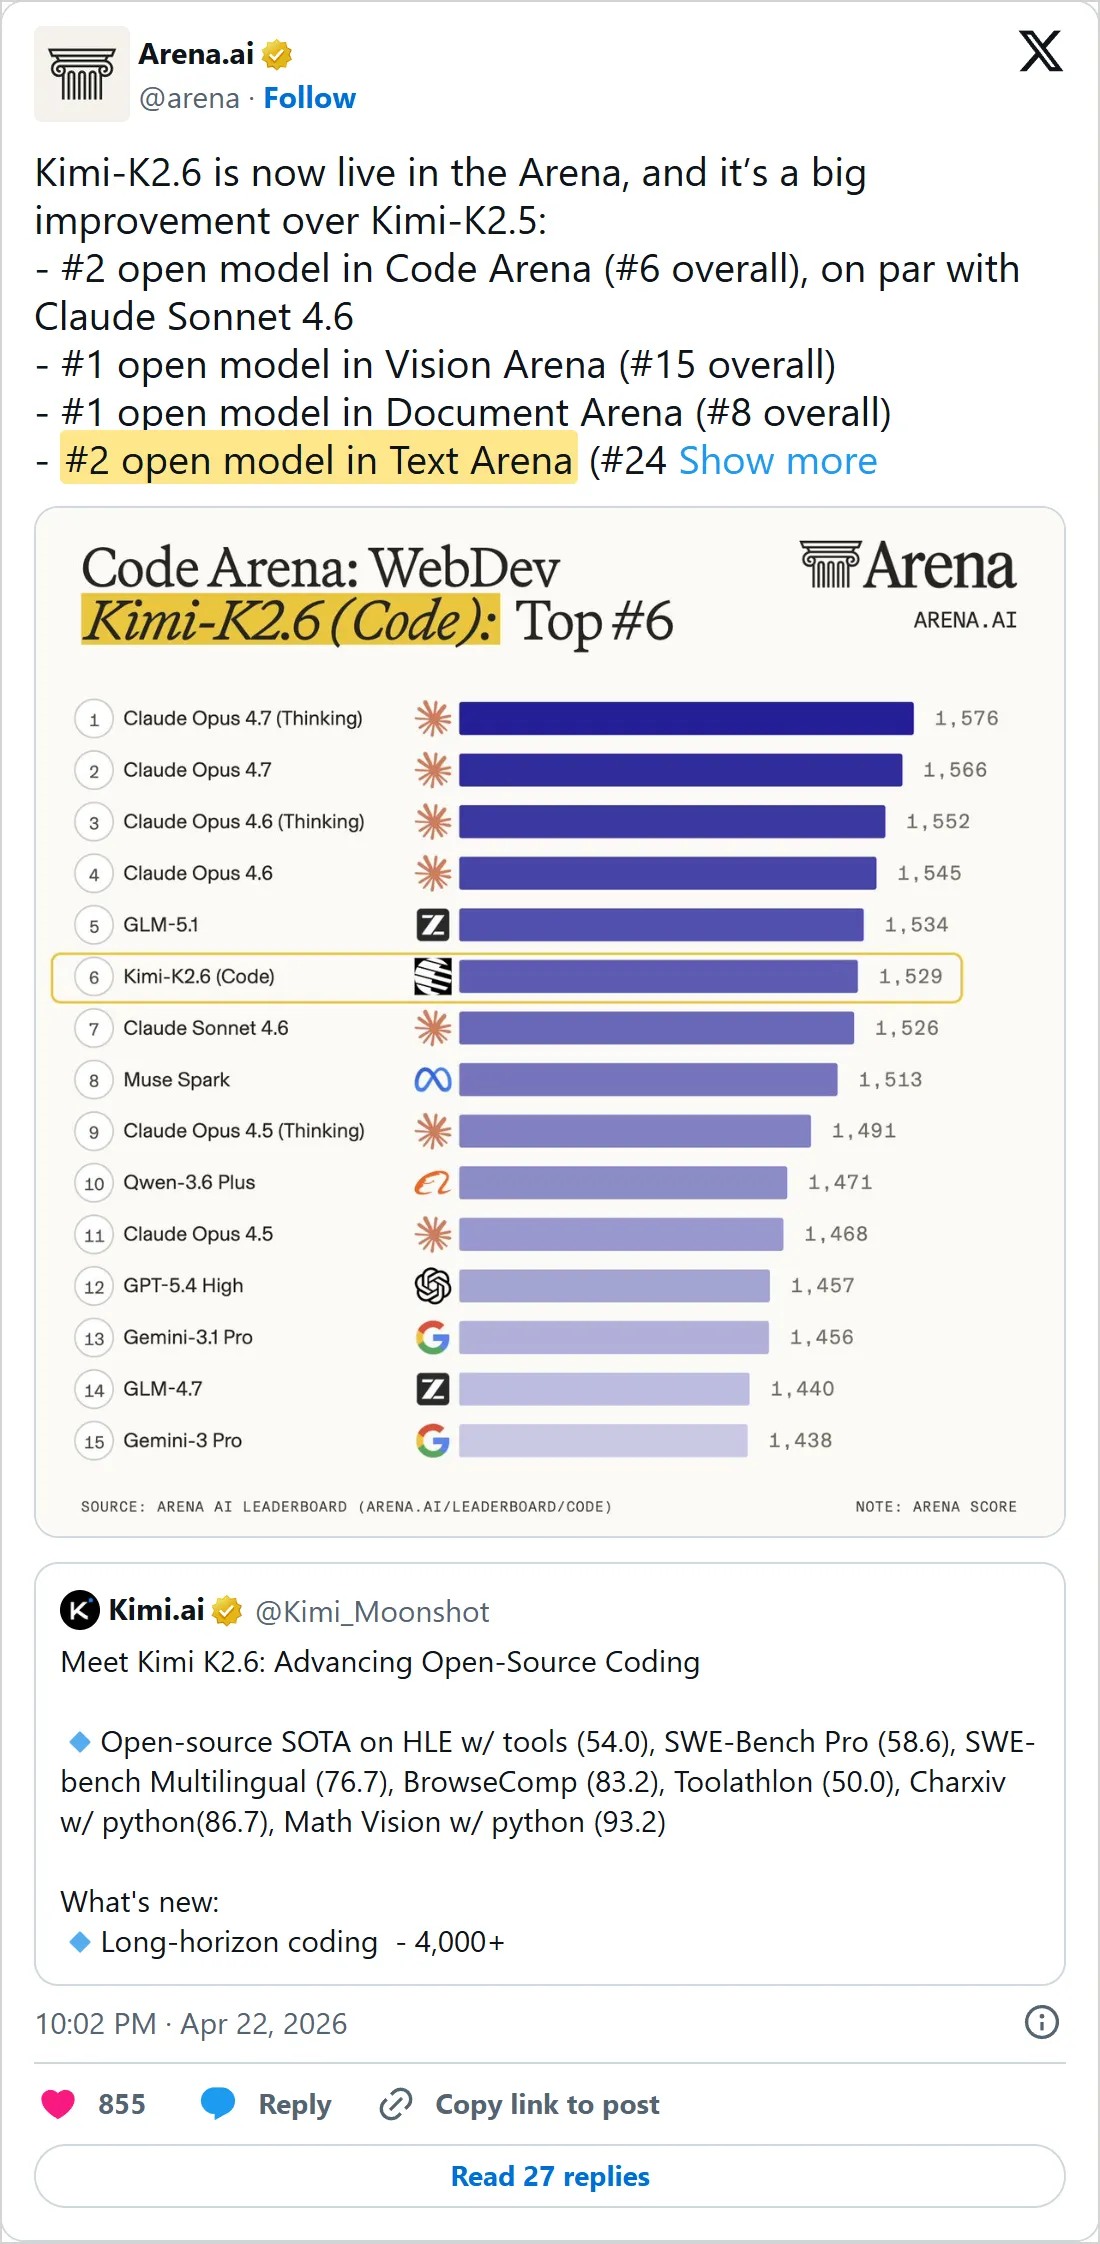
Arena 关于 Kimi K2.6 的帖子。图里是 Code Arena WebDev 榜,前五名中有四个是 Claude 模型。时间为 UTC。来源:x.com/arena/status/2047073519851438345
最新榜单上排名前十的实验室里,有五家来自中国:月之暗面、阿里巴巴、智谱、小米和 DeepSeek。2024 年 5 月,离榜首最近的中国实验室是零一万物,还差 48 分。智谱的 GLM 模型,也就是 ChatGLM 应用背后的模型,从 2026 年 2 月到 6 月一直是榜上最好的开放模型。
差距越来越小
Arena 文本榜第一名实验室与第十名实验室的分差
304
2023 年 5 月,榜上 17 个模型
168
2024 年 1 月
108
2025 年 1 月
43
2026 年 10 月,榜上 418 个模型
分差可以换算成胜率。在 Arena 的计分方式下,相差 400 分意味着强的一方十一次里赢十次。2023 年 5 月 304 分的差距,意味着 GPT-4 的回答对第十名实验室最好的模型大约有 85% 的胜率。到 2026 年 10 月,Google 的榜首对第十名实验室最好的模型,也就是 xAI 的 Grok 4.20 Beta,胜率只有 56% 左右。
差距缩小,一部分是因为参赛的多了。2023 年 5 月排第九、第十的实验室是 OpenAssistant 和智谱,模型都在 120 亿参数以内,放到一年后连前十都进不去。但更多是因为榜首之下的真实进步。如今前十的每一家都在这个差距之内,而 2024 年 6 月只有 OpenAI、Anthropic 和 Google 做得到。
实验室能刷 Arena 的分吗?
Meta 离这条线很近。2025 年 4 月 5 日发布 Llama 4 时,榜上的模型是 "Llama-4-Maverick-03-26-Experimental",在 4 月 8 日的榜单上以 1417 分排第二。随后 Arena 发帖说,Meta 对规则的理解"不符合我们对模型提供方的期待",并表示 Meta 应当讲清楚,这是一个"为迎合人类偏好而定制的模型"。Arena 给 Meta 正式公开的 Maverick 单独评分后,它的排名落在对手后面,在 4 月 23 日的榜单上是第 60 名。
同一个月,Cohere Labs 和几所大学的研究者发表了 The Leaderboard Illusion。他们分析了 2024 年 1 月到 2025 年 4 月的 200 万场对战,发现少数提供方可以私下测试很多个变体,只公开表现最好的那个,其中一家测了 27 个。从很多次尝试里挑最好的一次,就算没有哪个变体真的更强,分数也会被抬高。
按它的数据集说明,这段历史里 Arena 自己也改过三次算法:
- 2024 年 1 月 9 日: 评分从在线 Elo 改为 Bradley-Terry 拟合,把所有投票放在一起计算。
- 2025 年 5 月 16 日: 风格控制成为默认榜单。它扣除了更长、格式更花哨的回答在投票中天然占到的便宜,Arena 也把它调整到和原来同一个分数尺度上。
- 2025 年 7 月 23 日: Arena 加入了按出场频率对投票重新加权。
我们的图表跟随 Arena 当时默认展示的榜单:2025 年 4 月以前用原始评分,5 月起用风格控制后的评分。
文本投票不是比赛的全部
文本榜只回答一个问题:人们更愿意读哪个回答。Arena 现在为别的任务另开了榜单,各榜的领先者并不一样。网页开发榜在 2025 年 11 月并入主站。Agent Arena 评的是完整的智能体任务过程,而不是单次回答,它在 2026 年 6 月 4 日开放,用的是另一套计分方法。
Claude Fable 5.1 (Max) 就是个例子。它在当前文本榜上排第五,进入 Agent Arena 时却直接排在第一。
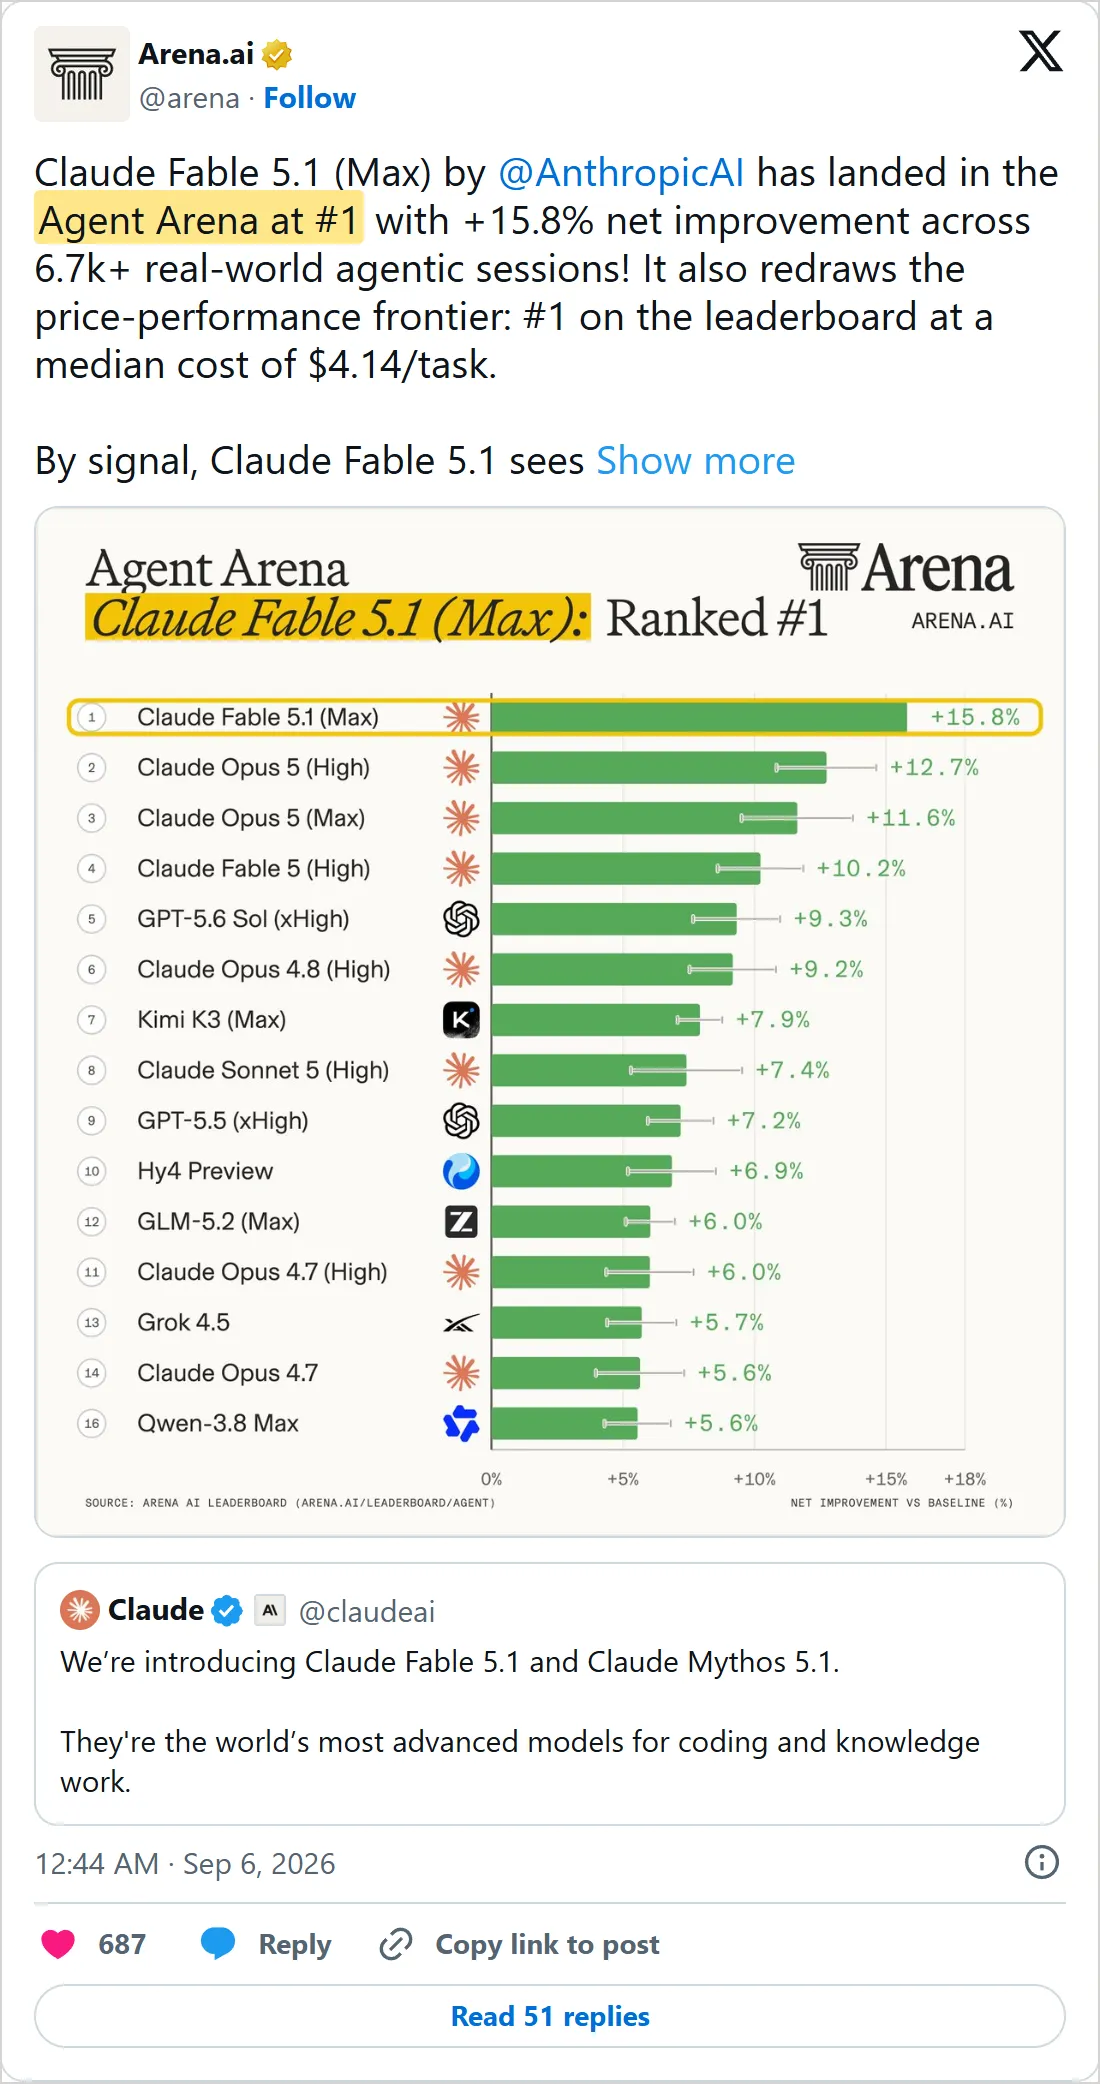
Arena 关于 Claude Fable 5.1 的 Agent Arena 帖子:6700 多场任务中净提升 15.8%,每项任务中位成本 4.14 美元。GPT-5.6 Sol (xHigh) 在这个榜上排第五。时间为 UTC。来源:x.com/arena/status/2096398986383184269
如果你的工作是写代码或跑智能体,这些专项榜更有参考价值。我们的 2026 年 6 月排行榜按任务类型综合了几个独立来源给模型排名。专项榜的分数和文本榜不在同一个尺度上,不能直接拿来比较。
2023 年以来的每一任第一,以及图表怎么做的
下表列出每次月底榜首模型发生变化的月份,模型名照 Arena 原样列出,分数取当月最后一版榜单。
| 月份 | 榜首模型(原名) | 实验室 | 分数 |
|---|---|---|---|
| 2023 年 5 月 | gpt-4 | OpenAI | 1,225 |
| 2023 年 11 月 | gpt-4-turbo | OpenAI | 1,210 |
| 2024 年 3 月 | claude-3-opus-20240229 | Anthropic | 1,253.6 |
| 2024 年 4 月 | gpt-4-turbo-2024-04-09 | OpenAI | 1,257.4 |
| 2024 年 5 月 | gpt-4o-2024-05-13 | OpenAI | 1,287.1 |
| 2024 年 8 月 | chatgpt-4o-latest | OpenAI | 1,316.2 |
| 2024 年 9 月 | o1-preview | OpenAI | 1,339.1 |
| 2024 年 10 月 | chatgpt-4o-latest-20240903 | OpenAI | 1,340.2 |
| 2024 年 11 月 | gemini-exp-1121 | 1,365.3 | |
| 2024 年 12 月 | gemini-exp-1206 | 1,373.5 | |
| 2025 年 1 月 | gemini-2.0-flash-thinking-exp-01-21 | 1,382.0 | |
| 2025 年 2 月 | early-grok-3 | xAI | 1,403.5 |
| 2025 年 3 月 | gemini-2.5-pro-exp-03-25 | 1,440.1 | |
| 2025 年 5 月 | gemini-2.5-pro-preview-05-06 | 1,446.0 | |
| 2025 年 6 月 | gemini-2.5-pro | 1,466.6 | |
| 2025 年 11 月 | gemini-3-pro | 1,492.4 | |
| 2026 年 2 月 | claude-opus-4-6-thinking | Anthropic | 1,503.4 |
| 2026 年 4 月 | claude-opus-4-7-thinking | Anthropic | 1,504.0 |
| 2026 年 5 月 | claude-opus-4-6-thinking | Anthropic | 1,502.2 |
| 2026 年 6 月 | claude-fable-5 | Anthropic | 1,508.2 |
| 2026 年 9 月 | gemini-4-argon-high | 1,524.8 |
图表的数据有两个来源,在 2025 年 9 月接上。此前的月份,我们读取 Arena 在 Hugging Face Space 里保存的榜单快照,每次更新一个文件。2025 年 9 月起读取 Arena 的历史数据集。只用数据集不够,因为它删掉了已退役的模型:Claude 1 和 2、Bard 以及所有 Gemini "exp" 版本都不在里面,而其中好几个当过第一。两个来源重叠的部分,我们比对过的每个模型分数都一模一样,精确到小数点后一位。
每家实验室的柱子按 Arena 的机构字段归类,所以 Vicuna 算 LMSYS,WizardLM 算微软。柱子上的标志来自开源图标库 Lobe Icons,版权归各公司所有。2023 年的榜单有几周显示在线 Elo,另几周显示自助抽样中位数,我们一律采用当时公开表格上印出的数字。
这份排名说明不了什么
投票衡量的是偏好,不是对错。投票的人如果自己不懂,一个自信的错误回答也能赢。投票者是主动访问模型对比网站的那群人,他们的问题不是你的问题。
柱子也看不出成本。一家实验室的最佳成绩,往往来自最贵的配置,比如 "Max" 或 "xHigh" 推理强度,价格可能是默认设置的好几倍。
常见问题
有没有 ChatGPT 3?
没有。GPT-3 在 2020 年发布,只通过 OpenAI 的 API 面向开发者。ChatGPT 到 2022 年底才出现,一上线用的就是 GPT-3.5,付费用户在 2023 年 3 月用上 GPT-4。我们的 ChatGPT 入门讲了这个应用和背后模型的关系。
现在 Claude 比 ChatGPT 强吗?
在当前文本榜上,Anthropic 最好的模型比 OpenAI 最好的模型高 24 分,换算下来,投票者约有 53% 的时候更喜欢 Claude 的回答。这是领先,不是碾压。AI 对比专题逐项比较了两款应用,我们的 Claude Pro 与 ChatGPT Plus 对比算了付费方案的账。
哪个模型坐第一的时间最长?
Gemini 2.5 Pro,把实验版、预览版和正式版算在一起,从 2025 年 3 月到 10 月连续八个月底排第一。最初的 GPT-4 是六个月,从 2023 年 5 月到 10 月。
分数是相对的,为什么榜首分数一直在涨?
Arena 用参照模型把分数尺度固定下来。2024 年 3 月到 2025 年 4 月,Mixtral 8x7B 在每一版榜单上都正好是 1114 分。新的榜首必须在一对一投票中赢过老榜首,所以顶端分数会慢慢往上爬。算法调整也会挪动尺度,跨好几年比较分数只能看个大概。
我可以使用这些数据吗?
可以。Arena 以 CC BY 4.0 许可证公开它的历史数据集,图表下方的月度 CSV 也列出了每家实验室每月的最高分和模型名。请注明 LMArena 为来源,并链接回本页说明实验室的归类方式。
更多 Mindber 内容
想看关注度而不是模型水平,我们的 AI 品牌竞赛用维基百科浏览量和 Google 搜索追踪了同一批公司。Claude Fable 5 指南讲了这个模型有什么不同。柱子背后的消费级应用各有页面:ChatGPT、Claude 和 Gemini,AI 聊天机器人目录收录了其余产品。
来源与方法
月度评分来自 Arena 的榜单快照(2023 年 5 月至 2025 年 8 月)和以 CC BY 4.0 许可公开的历史数据集(2025 年 9 月起),均于 2026-10-24 读取。2023 年以前的分数来自各模型论文。截图是 X 上的公开帖子,于 2026-10-24 通过 X 的嵌入页面截取。未做上手测试。
- [1]2023 年以来的文本总榜历史、模型所属机构与许可证,以及 Arena 在 2024 年 1 月、2025 年 5 月和 7 月的算法调整LMArena leaderboard dataset(Hugging Face,CC BY 4.0) · 2026-10-24
- [2]2023 年 5 月至 2025 年 8 月的榜单快照,包括已退役的模型Arena leaderboard Space(Hugging Face) · 2026-10-24
- [3]Chatbot Arena 于 2023 年 5 月 3 日上线及首版开放模型榜单LMSYS: Chatbot Arena, Benchmarking LLMs in the Wild · 2023-05-03
- [4]2023 年 5 月底榜单 GPT-4 以 1225 分居首,Claude 第二LMSYS: Chatbot Arena Leaderboard Updates (Week 4) · 2023-05-25
- [5]MMLU 的设计及 GPT-3 的 43.9% 成绩
- [6]Gopher 的 MMLU 成绩 60.0%
- [7]Chinchilla 的 MMLU 成绩 67.6%
- [8]PaLM 540B 的 MMLU 成绩 69.3%
- [9]LLaMA 65B 的 MMLU 成绩 63.4%
- [10]GPT-4 的 86.4% 与 GPT-3.5 的 70.0% MMLU 成绩OpenAI, GPT-4 Technical Report · 2023-03-15
- [11]2024 年 4 月 GPT-4 Turbo 夺回第一Arena(当时为 LMSYS)在 X 上的帖子 · 2024-04-11
- [12]GPT-4o 曾以 im-also-a-good-gpt2-chatbot 的名字在 Arena 测试Liam Fedus 在 X 上的帖子 · 2024-05-13
- [13]DeepSeek-R1 于 2025 年 1 月 20 日以 MIT 许可证发布DeepSeek API Docs: DeepSeek-R1 release · 2025-01-20
- [14]Gemini 2.5 Pro 以最大分数跃升登顶,测试代号 nebulaArena 在 X 上的帖子 · 2025-03-25
- [15]Arena 称 Meta 应说明实验版 Llama 4 Maverick 是定制模型Arena(当时为 LMArena)在 X 上的帖子 · 2025-04-08
- [16]公开版 Llama 4 Maverick 在 Arena 上排名落后于对手TechCrunch · 2025-04-11
- [17]风格控制:按回答长度和 Markdown 格式调整评分LMSYS: Does Style Matter? · 2024-08-28
- [18]私下测试多个模型变体,研究覆盖 200 万场对战,其中一家测试了 27 个变体Singh et al., The Leaderboard Illusion · 2025-04-29
- [19]Kimi K2.6 在文本榜开放模型中排第二Arena 在 X 上的帖子 · 2026-04-22
- [20]Claude Fable 5.1 (Max) 在 Agent Arena 排第一Arena 在 X 上的帖子 · 2026-09-06
- [21]Fable 5 于 2026 年 6 月 12 日停用、7 月 1 日恢复Anthropic: Redeploying Fable 5 · 2026-07-01
- [22]图表所用标志Lobe Icons,MIT 许可证 · 2026-10-24
在 Mindber 学习基础知识
本文的背景知识,来自 Mindber 免费学习中心。
分享这篇文章
法律声明
本出版物属于基于公开信息的编辑评论,不构成财务、法律、投资或专业建议。文中提及的产品名称、商标和注册商标均归其各自所有者所有;其出现并不代表认可或从属关系。Mindber 的分析反映基于公开信号的编辑判断,并可能随时变更,恕不另行通知。评分不是买入、卖出或持有建议。除非另有书面披露,Mindber 与被评估供应商不存在商业关系。本出版物受马来西亚法律管辖。因本出版物引起或与之相关的任何争议,均应提交马来西亚法院专属管辖。